
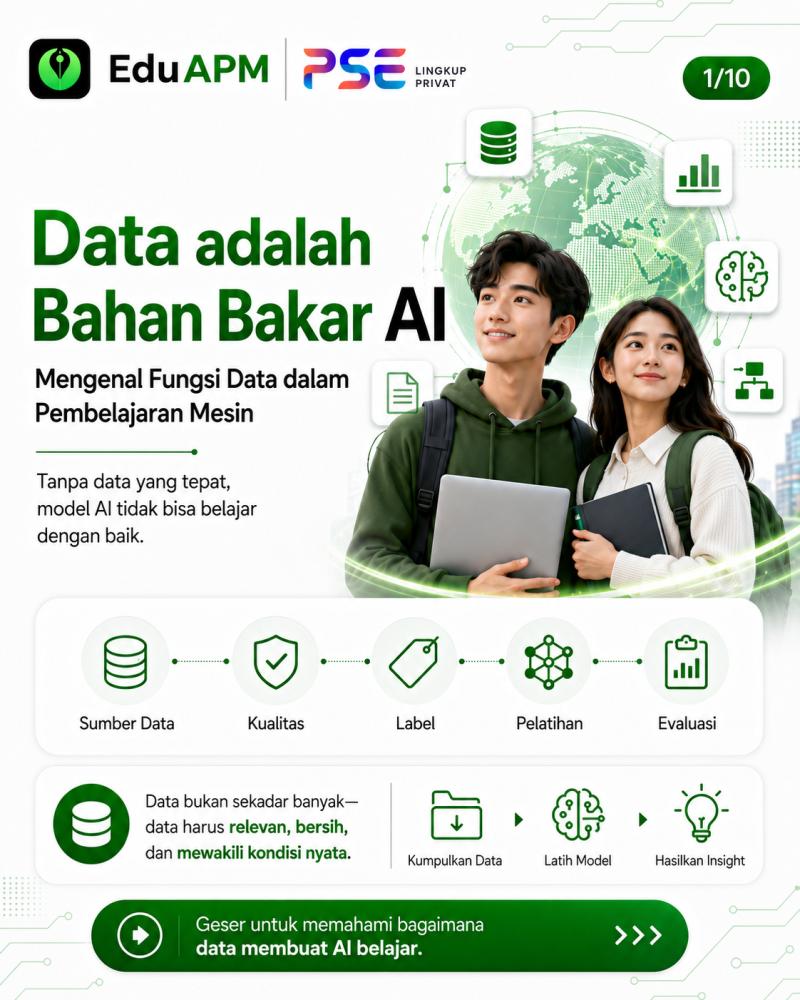
Ketika berbicara tentang kecerdasan buatan, banyak orang langsung memikirkan algoritma, robot, atau komputer canggih. Padahal, ada satu unsur yang jauh lebih mendasar, yaitu data. Tanpa data, sistem AI tidak memiliki bahan untuk belajar, mengenali pola, atau membuat keputusan.
Data sering disebut sebagai bahan bakar AI karena perannya mirip dengan bahan bakar pada kendaraan. Mesin yang canggih tidak akan bergerak tanpa energi, sedangkan model AI tidak akan bekerja dengan baik tanpa data. Semakin relevan dan berkualitas datanya, semakin besar peluang AI menghasilkan keluaran yang berguna.
Secara sederhana, data adalah kumpulan fakta atau catatan tentang suatu objek, peristiwa, aktivitas, atau kondisi. Data dapat berupa angka penjualan, foto wajah, rekaman suara, teks percakapan, lokasi kendaraan, suhu mesin, atau hasil ujian siswa. Bentuk data sangat beragam karena masalah yang ingin diselesaikan juga berbeda-beda.
Dalam pembelajaran mesin atau machine learning, komputer tidak hanya menjalankan aturan yang ditulis manusia. Komputer diberikan banyak contoh agar dapat menemukan pola sendiri. Proses inilah yang membuat data menjadi sangat penting, karena pola yang dipelajari model berasal dari contoh yang diberikan kepadanya.
Bayangkan seorang anak yang sedang belajar mengenali kucing. Ia melihat banyak gambar kucing dengan warna, ukuran, dan posisi yang berbeda. Dari berbagai contoh tersebut, anak mulai memahami ciri umum seekor kucing. Model machine learning bekerja dengan prinsip yang serupa, walaupun prosesnya dilakukan melalui perhitungan matematis.
Jika sebuah model hanya melihat satu atau dua gambar kucing, kemampuannya tentu masih terbatas. Model mungkin menganggap semua kucing harus berwarna putih atau selalu berada di dalam rumah. Karena itu, data perlu cukup beragam agar AI tidak hanya menghafal contoh tertentu, tetapi mampu mengenali pola yang lebih umum.
Tahap pertama dalam proyek pembelajaran mesin biasanya adalah mengumpulkan data. Data dapat berasal dari sistem transaksi, aplikasi, sensor, kamera, survei, dokumen, atau sumber terbuka. Praktisi tidak sekadar mencari data sebanyak mungkin, tetapi mempertimbangkan apakah data tersebut benar-benar berhubungan dengan masalah yang sedang diselesaikan.
Sebagai contoh, perusahaan ingin memprediksi pelanggan yang berpotensi berhenti menggunakan layanan. Data yang relevan dapat berupa lama berlangganan, frekuensi penggunaan, riwayat pembayaran, jumlah keluhan, dan jenis layanan. Warna favorit pelanggan mungkin menarik untuk diketahui, tetapi belum tentu berguna bagi tujuan prediksi tersebut.
Data dapat dibedakan menjadi data terstruktur dan tidak terstruktur. Data terstruktur tersusun rapi dalam tabel dengan baris dan kolom, seperti data penjualan atau daftar siswa. Data tidak terstruktur tidak memiliki susunan tabel yang sederhana, seperti gambar, video, suara, email, dan dokumen panjang.
Selain itu, ada data semi-terstruktur yang memiliki pola tertentu tetapi tidak sepenuhnya berbentuk tabel. Contohnya adalah data dari aplikasi, log sistem, atau berkas digital dengan penanda tertentu. Memahami bentuk data membantu praktisi menentukan cara penyimpanan, pengolahan, dan metode analisis yang paling tepat.
Setelah data dikumpulkan, data biasanya belum langsung siap digunakan. Dalam dunia nyata, data sering memiliki banyak masalah, seperti kolom kosong, penulisan berbeda, angka yang salah, data ganda, atau format tanggal yang tidak seragam. Karena itu, proses pembersihan data merupakan bagian besar dalam pekerjaan AI.
Pembersihan data bertujuan memperbaiki kualitas informasi sebelum digunakan untuk melatih model. Misalnya, nama kota “Jakarta”, “DKI Jakarta”, dan “Jkt” mungkin merujuk pada tempat yang sama. Jika perbedaan tersebut tidak diperbaiki, sistem dapat menganggapnya sebagai tiga kategori yang berbeda.
Kesalahan kecil dalam data dapat memberi pengaruh besar pada hasil model. Jika umur pelanggan tertulis 250 tahun karena salah memasukkan angka, model dapat mempelajari hubungan yang tidak masuk akal. Praktisi perlu memeriksa nilai ekstrem dan menentukan apakah nilai tersebut valid atau merupakan kesalahan.
Data juga perlu memiliki label dalam beberapa jenis pembelajaran mesin. Label adalah jawaban atau kategori yang ingin dipelajari model. Dalam sistem pendeteksi spam, setiap email dapat diberi label “spam” atau “bukan spam”. Model kemudian mempelajari perbedaan pola di antara kedua kelompok tersebut.
Proses memberi label disebut anotasi data. Anotasi dapat dilakukan pada teks, gambar, suara, maupun video. Pada gambar jalan raya, manusia dapat menandai lokasi mobil, pejalan kaki, dan rambu lalu lintas. Hasil anotasi tersebut menjadi contoh bagi model untuk belajar mengenali objek.
Kualitas label sama pentingnya dengan kualitas data. Jika sebuah gambar mobil diberi label sepeda, model akan menerima contoh yang salah. Apabila kesalahan semacam itu terjadi dalam jumlah besar, kemampuan model dapat menurun dan hasil prediksinya menjadi tidak dapat dipercaya.
Data yang digunakan untuk mengembangkan model biasanya dibagi menjadi beberapa bagian. Data pelatihan digunakan untuk mengajarkan pola kepada model. Data validasi digunakan untuk membantu memilih pengaturan model. Sementara data pengujian digunakan untuk menilai kemampuan model pada data yang belum pernah dilihat sebelumnya.
Pembagian tersebut penting agar praktisi dapat mengetahui apakah model benar-benar belajar atau hanya menghafal data pelatihan. Model yang terlalu menghafal disebut mengalami overfitting. Model seperti ini terlihat sangat baik saat diuji dengan data lama, tetapi gagal ketika menghadapi data baru.
Sebaliknya, model dapat mengalami underfitting jika belum mampu memahami pola penting dalam data. Hal ini bisa terjadi karena model terlalu sederhana, data terlalu sedikit, atau proses pelatihan belum cukup. Praktisi perlu mencari keseimbangan agar model mampu belajar dengan baik tanpa sekadar menghafal.
Jumlah data memang penting, tetapi jumlah besar tidak selalu berarti kualitas tinggi. Satu juta catatan yang salah, tidak relevan, atau berulang dapat lebih buruk daripada sepuluh ribu catatan yang bersih dan mewakili kondisi nyata. Dalam praktik, kualitas, keberagaman, dan relevansi sering lebih penting daripada sekadar volume.
Keberagaman data membantu model menghadapi berbagai kondisi. Sistem pengenalan wajah, misalnya, perlu belajar dari variasi pencahayaan, sudut wajah, usia, dan tampilan pengguna. Jika data pelatihan terlalu seragam, model mungkin bekerja baik pada kelompok tertentu tetapi buruk pada kelompok lainnya.
Masalah ketidakseimbangan data juga sering terjadi. Dalam deteksi penipuan, jumlah transaksi normal biasanya jauh lebih banyak daripada transaksi curang. Jika kondisi ini tidak ditangani, model dapat selalu memilih jawaban “normal” dan tetap terlihat akurat, padahal gagal menemukan kasus yang paling penting.
Praktisi mengatasi ketidakseimbangan data dengan berbagai cara, seperti menambah contoh kategori yang sedikit, mengurangi kategori yang terlalu banyak, atau menggunakan ukuran evaluasi yang sesuai. Mereka tidak hanya melihat angka akurasi, tetapi juga memeriksa seberapa baik model menemukan kasus yang benar-benar penting.
Data dapat menjadi sumber bias apabila tidak mewakili kondisi sebenarnya. Jika sistem rekrutmen belajar hanya dari riwayat pekerja pada masa lalu yang tidak seimbang, model dapat meneruskan ketimpangan tersebut. AI tidak menciptakan keadilan secara otomatis karena ia belajar dari pola yang tersedia dalam data.
Oleh karena itu, pemeriksaan data perlu dilakukan sebelum model dibangun. Praktisi perlu menanyakan siapa yang tercakup dalam data, siapa yang tidak terwakili, bagaimana data dikumpulkan, dan apakah ada pola yang dapat merugikan kelompok tertentu. Pertanyaan seperti ini merupakan bagian dari pengembangan AI yang bertanggung jawab.
Data juga berkaitan erat dengan privasi. Informasi pribadi seperti nama, alamat, nomor identitas, riwayat kesehatan, dan lokasi tidak boleh digunakan sembarangan. Organisasi perlu memiliki tujuan yang jelas, perlindungan yang memadai, dan izin yang sesuai ketika mengumpulkan serta menggunakan data.
Salah satu cara melindungi privasi adalah menghapus atau menyamarkan informasi yang dapat mengidentifikasi seseorang. Akses terhadap data juga perlu dibatasi hanya kepada pihak yang berwenang. Keamanan data bukan sekadar masalah teknis, tetapi bagian dari kepercayaan antara organisasi dan pengguna.
Setelah model digunakan, pekerjaan terhadap data belum selesai. Pola di dunia nyata dapat berubah seiring waktu. Kebiasaan pelanggan, kondisi pasar, bahasa pengguna, dan perilaku mesin dapat berubah sehingga model lama menjadi kurang akurat. Kondisi ini sering disebut data drift.
Karena itu, sistem AI perlu dipantau secara berkala. Praktisi membandingkan data baru dengan data pelatihan, memeriksa hasil prediksi, dan melihat apakah performa menurun. Jika terjadi perubahan besar, data baru dapat digunakan untuk melatih ulang atau memperbarui model.
Bagi pemula, memahami data sebaiknya dimulai dari proyek sederhana. Cobalah mengumpulkan data kecil, membersihkannya, membuat grafik, dan mencari pola. Dari kegiatan tersebut, kita akan memahami bahwa keberhasilan AI bukan hanya ditentukan oleh algoritma yang rumit, tetapi oleh data yang disiapkan dengan benar.
Pada akhirnya, data memang dapat disebut sebagai bahan bakar AI, tetapi bahan bakar tersebut harus tepat, bersih, aman, dan sesuai kebutuhan. Model yang baik lahir dari data yang baik, proses yang disiplin, dan pengawasan manusia. Jika data dipahami serta dikelola dengan bijak, AI dapat memberikan manfaat yang lebih akurat, adil, dan relevan bagi kehidupan manusia.